
RAG (Retrieval-Augmented Generation) adalah teknik yang memungkinkan model AI mengakses informasi dari sumber eksternal sebelum menghasilkan jawaban, sehingga hasilnya lebih akurat, terkini, dan dapat diverifikasi. Tidak seperti chatbot biasa yang hanya mengandalkan data lama dari masa pelatihan, sistem berbasis RAG bisa membaca dokumen baru secara dinamis dan menjawab berdasarkan isi dokumen tersebut.
Sebagian besar orang yang baru mengenal dunia AI Engineering akan menemukan kata “RAG” di mana-mana: di deskripsi lowongan kerja, di kurikulum program intensif, di forum teknologi, bahkan di presentasi internal perusahaan. Tapi penjelasannya hampir selalu sama, terlalu teknikal, penuh jargon, dan tidak pernah menjawab dua pertanyaan paling mendasar: kenapa ini penting, dan apakah bisa dipelajari oleh orang yang belum punya latar belakang IT?
Jawabannya: bisa. Artikel ini menjelaskan RAG dari nol, termasuk masalah nyata yang melahirkannya, cara kerjanya langkah per langkah, perbandingan dengan teknik AI lain, tools yang dipakai di industri, dan kenapa skill ini menjadi salah satu yang paling dicari dari seorang AI Engineer hari ini.
Apa Itu RAG (Retrieval-Augmented Generation)?
RAG adalah teknik dalam pengembangan sistem AI yang menggabungkan dua kemampuan utama: mencari informasi yang relevan dari sumber eksternal (retrieval) dan menghasilkan jawaban berdasarkan informasi tersebut (generation). Hasilnya adalah model AI yang tidak hanya pandai menyusun kalimat, tapi juga pandai merujuk fakta yang benar dan terkini sebelum menjawab.
Untuk memahaminya, bayangkan dua jenis asisten. Asisten pertama hafal semua buku yang pernah dia baca, tapi pengetahuannya berhenti di hari terakhir dia belajar. Kalau kamu tanya soal peraturan perusahaan yang baru diperbarui bulan lalu, atau harga produk yang berubah minggu kemarin, dia tidak tahu. Asisten kedua punya cara kerja yang berbeda: sebelum menjawab, dia membuka perpustakaan, mencari referensi yang paling relevan dengan pertanyaanmu, lalu menyusun jawaban berdasarkan dokumen yang baru saja dia baca.
Asisten pertama adalah LLM (Large Language Model) konvensional seperti ChatGPT tanpa akses data eksternal. Asisten kedua adalah sistem berbasis RAG.
Konsep ini pertama kali dipublikasikan oleh tim Facebook AI Research dalam paper berjudul Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks di konferensi NeurIPS 2020. Sejak saat itu, RAG berkembang menjadi arsitektur standar yang digunakan oleh perusahaan teknologi besar di seluruh dunia untuk membangun aplikasi AI yang benar-benar bisa diandalkan dalam konteks bisnis.
Penting untuk dipahami: RAG bukan pengganti LLM. RAG adalah lapisan tambahan yang membuat LLM menjadi jauh lebih berguna di dunia nyata. Peran LLM tetap ada, yaitu memahami pertanyaan dan menyusun jawaban. Tapi sekarang dia punya “catatan” yang bisa dirujuk sebelum menjawab.
Masalah yang Membuat RAG Lahir: Halusinasi AI dan Knowledge Cutoff
Sebelum memahami cara kerja RAG lebih dalam, penting untuk tahu masalah apa yang ingin diselesaikannya. Karena tanpa memahami masalahnya, sulit untuk benar-benar menghargai kenapa teknik ini menjadi begitu penting.
LLM seperti GPT, Claude, atau Gemini dilatih menggunakan data teks dalam jumlah yang sangat besar, mulai dari buku, artikel, dokumentasi teknis, hingga percakapan di internet. Dari sana mereka belajar pola bahasa, fakta, logika, dan cara menyusun kalimat yang bermakna. Tapi ada dua kelemahan mendasar yang melekat pada cara kerja ini.
Pertama: knowledge cutoff. Setiap LLM punya tanggal “batas belajar”. Informasi setelah tanggal itu tidak akan diketahui model, kecuali ada mekanisme tambahan. Kalau kamu tanya soal perubahan regulasi yang baru berlaku bulan lalu, kebijakan internal perusahaan yang baru diterbitkan, atau harga produk yang baru diperbarui, model akan menjawab berdasarkan data lama, atau tidak menjawab sama sekali.
Kedua: halusinasi (hallucination). Ini adalah kondisi ketika model AI menghasilkan jawaban yang terdengar sangat meyakinkan, tapi faktanya salah atau bahkan tidak ada. Model tidak punya kemampuan bawaan untuk memeriksa apakah sebuah informasi benar. Dia hanya memprediksi kata berikutnya berdasarkan pola statistik dari data pelatihannya.
Contohnya sederhana tapi serius: chatbot layanan pelanggan yang dengan percaya diri menyebut syarat produk yang sudah tidak berlaku, asisten hukum yang mengutip pasal yang tidak ada dalam undang-undang, atau sistem HR yang memberikan informasi tunjangan berdasarkan kebijakan lama yang sudah direvisi.
Dua masalah ini menjadi sangat kritis ketika AI mulai dipakai di konteks bisnis yang nyata, di mana akurasi informasi bukan sekadar kenyamanan, tapi keharusan. RAG hadir sebagai solusi untuk keduanya. Dengan menghubungkan LLM ke sumber data eksternal yang bisa diperbarui kapan saja, sistem berbasis RAG bisa menjawab berdasarkan fakta aktual, bukan hanya berdasarkan memori lama yang mungkin sudah tidak relevan.
Cara Kerja RAG: 3 Tahap yang Perlu Anda Pahami
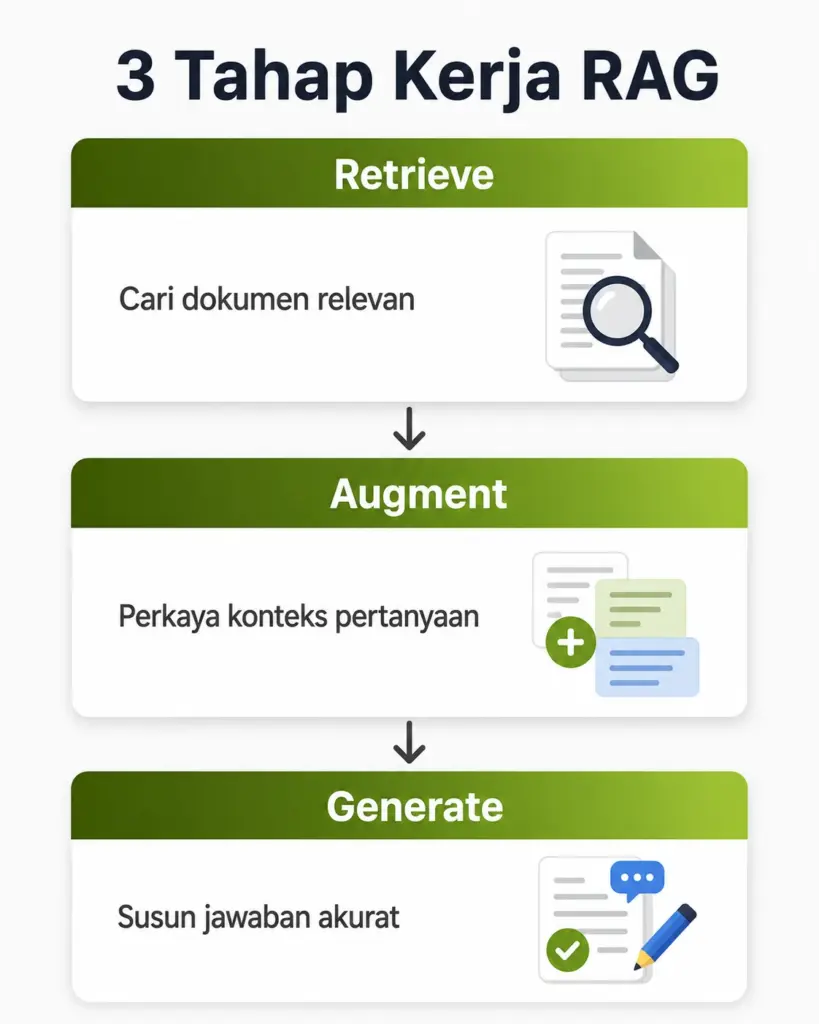
Cara kerja RAG bisa dipecah menjadi tiga tahap yang berjalan berurutan setiap kali pengguna mengajukan pertanyaan ke sistem. Memahami ketiga tahap ini adalah fondasi untuk bisa bekerja dengan RAG secara praktis.
1. Retrieve: Pencarian Informasi yang Relevan
Saat pengguna mengirimkan pertanyaan, sistem tidak langsung meneruskannya ke LLM. Pertanyaan itu lebih dulu diubah menjadi representasi matematis yang disebut embedding, semacam “sidik jari makna” dari kalimat tersebut dalam bentuk angka-angka.
Embedding ini kemudian dicocokkan dengan dokumen-dokumen yang sudah tersimpan di vector database, yaitu basis data khusus yang menyimpan dokumen juga dalam bentuk embedding. Sistem mencari dokumen yang paling relevan secara semantik, bukan hanya berdasarkan kecocokan kata kunci persis. Ini berarti pertanyaan “berapa gaji untuk posisi ini?” tetap bisa menemukan dokumen yang menyebut “kompensasi untuk jabatan tersebut” karena maknanya mirip, meski katanya berbeda.
Hasilnya adalah sekumpulan potongan dokumen (passages) yang paling relevan dengan pertanyaan pengguna, biasanya diambil dalam jumlah tertentu yang disebut top-k results.
2. Augment: Pengayaan Konteks Sebelum Dikirim ke LLM
Potongan dokumen yang ditemukan tadi digabungkan dengan pertanyaan asli pengguna untuk membentuk sebuah prompt yang lebih kaya. Proses ini disebut context augmentation.
Hasilnya bukan lagi pertanyaan sederhana. Melainkan pertanyaan yang dilengkapi dengan dokumen referensi, kurang lebih seperti ini: “Berdasarkan dokumen berikut ini, jawab pertanyaan pengguna.” Dokumen referensi itulah yang menjadi “catatan” bagi LLM saat menyusun jawaban.
3. Generate: LLM Menyusun Jawaban Berdasarkan Konteks
Prompt yang sudah diperkaya konteks tersebut dikirim ke LLM. Model kemudian menyusun jawaban berdasarkan dua hal sekaligus: pertanyaan asli pengguna, dan dokumen yang disertakan dalam prompt. Bukan hanya berdasarkan memori bawaan model dari masa pelatihan.
Hasilnya adalah jawaban yang lebih akurat, lebih relevan dengan situasi spesifik pengguna, dan bisa ditelusuri sumbernya. Karena jawaban dibangun berdasarkan dokumen nyata yang disertakan, risiko halusinasi turun secara signifikan. Kalau dokumennya tidak menyebut sesuatu, model idealnya tidak akan mengarang.
Ketiga tahap ini terkesan sederhana di permukaan, tapi di baliknya ada banyak keputusan teknis yang harus dibuat: vector database apa yang dipakai, model embedding mana yang digunakan, bagaimana strategi memotong dokumen menjadi potongan-potongan kecil (chunking), dan bagaimana cara mengevaluasi kualitas hasil retrieval. Semua keputusan itu adalah bagian dari pekerjaan nyata seorang AI Engineer yang membangun sistem RAG di lingkungan produksi.
RAG vs Fine-Tuning vs Prompt Engineering: Mana yang Tepat?
Ketika pertama kali belajar tentang cara meningkatkan performa AI, tiga nama ini hampir selalu muncul bersamaan. Ketiganya berbeda secara fundamental dalam cara kerja, biaya, dan konteks penggunaan yang paling tepat.
Sebelum masuk ke perbandingan, penting untuk dipahami: ketiga teknik ini bukan saingan satu sama lain. Masing-masing punya tempat yang tepat, dan banyak tim AI di industri menggunakan kombinasi ketiganya secara bersamaan.
| Aspek | RAG | Fine-Tuning | Prompt Engineering |
| Cara kerja | Hubungkan LLM ke sumber data eksternal saat digunakan (inference time) | Latih ulang model dengan data baru sebelum digunakan (training time) | Perbaiki cara pertanyaan diajukan ke model, tanpa mengubah model itu sendiri |
| Kebutuhan data | Dokumen atau basis data yang bisa diperbarui kapan saja | Dataset berlabel: ribuan hingga ratusan ribu sampel | Tidak butuh data training baru |
| Biaya | Sedang: butuh vector database dan infrastruktur retrieval | Tinggi: butuh GPU, waktu training, dan dataset yang disiapkan | Rendah, hanya butuh waktu eksperimen |
| Kecepatan update data | Sangat cepat: tambah dokumen baru tanpa training ulang | Lambat: harus training ulang setiap kali ada data baru yang ingin diinternalisasi | Tidak relevan untuk update data |
| Cocok untuk | Dokumen internal perusahaan, data yang sering berubah, chatbot berbasis knowledge base | Gaya bahasa atau tone spesifik, task sempit dengan presisi tinggi, model yang perlu mengadopsi “karakter” tertentu | Optimasi cepat tanpa infrastruktur tambahan, eksperimen awal |
Cara paling mudah untuk membedakan RAG dan fine-tuning: jika masalahnya adalah “model tidak tahu informasi ini karena datanya baru atau privat,” solusinya RAG. Jika masalahnya adalah “model tahu informasinya tapi cara merespons atau gaya bahasanya tidak sesuai,” solusinya fine-tuning.
Prompt engineering biasanya menjadi langkah pertama sebelum memutuskan apakah perlu RAG atau fine-tuning, karena biayanya paling rendah dan hasilnya bisa langsung terlihat.
Tools RAG yang Wajib Dikuasai AI Engineer
Memahami konsep RAG saja tidak cukup untuk bekerja sebagai AI Engineer. Perusahaan membutuhkan orang yang bisa membangun sistem RAG yang nyata dengan tools yang sudah dipakai industri. Berikut adalah tools yang paling sering muncul dalam konteks RAG saat ini dan relevan untuk dikuasai:
LangChain Framework orkestrasi LLM yang paling populer dan paling banyak dokumentasinya. LangChain menyediakan komponen siap pakai untuk membangun pipeline RAG lengkap: document loader, text splitter, embeddings, integrasi berbagai vector store, dan chain management. Bagi pemula, LangChain adalah titik masuk yang paling lazim karena ekosistemnya besar dan tutorialnya berlimpah.
LlamaIndex Alternatif LangChain yang lebih fokus pada pembangunan sistem RAG berbasis dokumen yang kompleks. LlamaIndex unggul dalam mengelola dokumen besar, menyediakan fitur indexing yang lebih granular, dan sering menjadi pilihan ketika struktur dokumen sumber bervariasi (PDF, tabel, presentasi).
Pinecone Vector database berbasis cloud yang paling banyak dipakai di lingkungan produksi. Menawarkan performa pencarian semantik yang cepat dan skalabel tanpa harus mengelola infrastruktur server sendiri. Pilihan umum ketika aplikasi sudah beranjak dari prototipe menuju production.
ChromaDB Vector database open-source yang ringan dan mudah dijalankan secara lokal di komputer sendiri. Pilihan ideal untuk eksperimen awal, prototipe, atau proyek berskala kecil-menengah. Kurva belajarnya rendah dan tidak butuh akun berbayar untuk memulai.
FAISS (Facebook AI Similarity Search) Library open-source dari Meta yang sangat efisien untuk pencarian vektor dalam skala besar. Sering dipakai ketika performa pencarian menjadi prioritas utama dan tim ingin kontrol penuh atas infrastruktur tanpa bergantung pada layanan cloud.
Weaviate Vector database open-source yang semakin banyak dipakai untuk kasus enterprise. Menawarkan fitur hybrid search yang menggabungkan pencarian semantik dan pencarian kata kunci, berguna ketika akurasi retrieval sangat krusial.
Untuk memulai belajar RAG secara praktis, kamu tidak perlu menguasai semua tools sekaligus. Fokus pada LangChain sebagai framework utama, ditambah satu vector database (ChromaDB untuk lokal atau Pinecone untuk cloud), sudah cukup sebagai fondasi yang solid.
Untuk daftar skills dan tools AI Engineer yang lebih lengkap, termasuk stack di luar RAG, kamu bisa cek di artikel 10 Skill dan Tools Wajib AI Engineer 2026.
Kenapa AI Engineer di Indonesia Wajib Kuasai RAG?
RAG bukan sekadar konsep akademis yang menarik untuk dipelajari di kelas. Di dunia kerja nyata saat ini, ini adalah skill yang secara eksplisit dicari ketika perusahaan merekrut AI Engineer.
Coba perhatikan deskripsi lowongan AI Engineer dari perusahaan-perusahaan teknologi Indonesia di 2025-2026: kata “RAG”, “LangChain”, “vector database“, dan “LLM application development” muncul berulang kali di bagian requirements. Ini bukan tren sesaat.
Ada beberapa alasan konkret mengapa permintaan terhadap skill RAG meningkat pesat, terutama dalam konteks pasar kerja Indonesia:
Perusahaan butuh AI yang bisa menggunakan data internal mereka. Chatbot berbasis LLM murni tidak bisa menjawab pertanyaan tentang SOP internal perusahaan yang baru diperbarui minggu lalu, produk yang baru diluncurkan, atau kebijakan yang baru direvisi. RAG memungkinkan perusahaan membangun asisten AI yang “tahu” isi database internal mereka, tanpa harus mengirimkan data sensitif ke penyedia LLM pihak ketiga.
Sektor perbankan dan keuangan memimpin adopsi. Institusi keuangan di Indonesia mulai membangun chatbot internal untuk tim operasional dan layanan nasabah. Sistem ini membutuhkan RAG agar bisa merujuk ke regulasi terbaru, prosedur internal yang berubah, dan data produk yang terus berkembang, semuanya dengan akurasi yang bisa dipertanggungjawabkan.
Fintech dan startup bergerak lebih cepat. Banyak startup Indonesia kini membangun produk berbasis AI, dari agen customer service hingga asisten analisis data. RAG menjadi komponen standar dalam arsitektur produk mereka karena memungkinkan produk AI yang “hidup” dan relevan tanpa harus melatih ulang model dari awal setiap kali ada perubahan data.
HR tech dan legal tech mulai mengadopsi. Pengelolaan dokumen kontrak, knowledge base kebijakan karyawan, dan repositori regulasi hukum adalah use case yang sangat cocok untuk RAG. Datanya besar, sering diperbarui, dan membutuhkan jawaban yang akurat dan bisa ditelusuri sumbernya.
Satu hal yang sering diabaikan: skill RAG juga membuka pintu ke peran yang lebih senior. LLM Engineer dan AI Engineer yang bisa merancang arsitektur RAG dari awal, mengevaluasi kualitas retrieval, dan mengoptimasi pipeline untuk skala produksi, adalah profil yang paling banyak dicari oleh perusahaan yang serius berinvestasi di AI.
Yang menarik untuk dipahami: skill RAG bisa dipelajari dari nol, termasuk oleh mereka yang belum punya latar belakang IT sama sekali, selama belajar dengan struktur yang tepat dan langsung mempraktikkan di proyek nyata. Informasi lengkap tentang prospek dan jalur karier bisa dibaca di artikel karier AI Engineer di Indonesia: skill, gaji, dan roadmap.
Ingin belajar RAG langsung dengan proyek nyata yang relevan di industri? Lihat kurikulum dan jadwal kelas malam AI Engineering Bootcamp Rework Academy di reworkacademy.com/ai-engineering-bootcamp.
Tantangan dalam Implementasi RAG yang Perlu Anda Tahu
RAG bukan solusi yang langsung sempurna begitu dipasang. Ada tantangan nyata yang perlu dipahami, baik untuk membangun ekspektasi yang realistis maupun untuk mengerti kenapa skill ini justru bernilai tinggi.
Kualitas retrieval menentukan segalanya. Jika sistem pencarian gagal menemukan dokumen yang benar-benar relevan, LLM akan menyusun jawaban berdasarkan konteks yang salah. Outputnya bisa tetap terdengar meyakinkan, tapi isinya keliru. Dalam komunitas AI Engineering, ini dikenal dengan ungkapan “garbage in, garbage out.” Kualitas embedding model, strategi chunking, dan kebersihan data sumber adalah faktor penentu yang tidak bisa diabaikan.
Latensi lebih tinggi dibanding LLM murni. Berbeda dengan model konvensional yang langsung menjawab setelah menerima input, sistem RAG harus melalui proses pencarian dokumen terlebih dahulu sebelum menghasilkan jawaban. Pada sistem real-time seperti customer service atau asisten interaktif, peningkatan latensi ini perlu dioptimasi dengan cermat agar tidak terasa mengganggu bagi pengguna.
Knowledge base butuh perawatan rutin. Dokumen yang digunakan sebagai sumber harus selalu relevan, bersih, dan terstruktur dengan baik. Basis data yang berisi dokumen usang, duplikat, atau tidak konsisten justru bisa membuat sistem menghasilkan jawaban yang lebih menyesatkan dibanding tidak memakai RAG sama sekali. Ini berarti ada tanggung jawab operasional yang berkelanjutan, bukan hanya kerja sekali selesai.
Evaluasi sistem lebih kompleks dari LLM biasa. Karena output akhir dipengaruhi oleh dua komponen (retriever dan generator), kesalahan bisa datang dari berbagai titik. Dibutuhkan strategi evaluasi khusus untuk mengisolasi masalah: apakah retrieval yang salah memilih dokumen, atau LLM yang salah menafsirkan dokumen yang sudah benar ditemukan? Framework seperti RAGAS (Retrieval-Augmented Generation Assessment) mulai banyak dipakai untuk evaluasi ini.
Biaya infrastruktur perlu diperhitungkan. Meskipun tidak membutuhkan training model dari awal, sistem RAG membutuhkan vector database, biaya komputasi untuk embedding dan pencarian, serta infrastruktur pengelolaan dokumen. Untuk skala kecil ini tidak masalah, tapi untuk sistem produksi skala besar, perencanaan biaya menjadi bagian penting dari desain arsitektur.
Tantangan-tantangan ini bukan untuk menakut-nakuti. Justru sebaliknya: inilah yang membuat skill RAG bernilai tinggi. Membangun sistem RAG yang berfungsi sebagai prototipe mudah. Membangun yang production-ready, efisien, akurat, dan bisa dimaintain dalam jangka panjang adalah tantangan yang membutuhkan keahlian nyata.
FAQ: Pertanyaan Umum tentang RAG
Apakah RAG sama dengan ChatGPT?
Tidak. ChatGPT adalah produk AI yang dikembangkan OpenAI, berbasis LLM bernama GPT. RAG adalah teknik arsitektur yang bisa diterapkan pada LLM apa pun, termasuk GPT, Claude, Gemini, atau Llama. Fitur “web browsing” atau “search” yang ada di beberapa produk AI berbasis prinsip yang mirip dengan RAG, yaitu mengambil informasi dari sumber eksternal sebelum menjawab. Tapi RAG sebagai teknik lebih luas dari itu dan bisa dikustomisasi penuh oleh developer.
Apa bedanya RAG dengan fine-tuning?
Fine-tuning mengubah parameter internal model dengan melatihnya kembali menggunakan data baru. Model yang sudah di-fine-tune “menginternalisasi” pengetahuan baru itu ke dalam dirinya. RAG tidak mengubah model sama sekali. RAG menyediakan informasi eksternal secara dinamis setiap kali model digunakan. Singkatnya: fine-tuning cocok untuk mengubah “karakter” atau “spesialisasi” model, RAG cocok untuk memberikan model akses ke pengetahuan yang terus diperbarui.
Apakah bisa belajar RAG tanpa background programming?
Belajar RAG membutuhkan pemahaman dasar pemrograman, terutama Python. Tapi tidak berarti harus punya latar belakang IT formal terlebih dahulu. Banyak AI Engineer saat ini berkarier dari background non-teknis yang belajar secara terstruktur melalui program yang dirancang untuk pemula. Panduan lengkap untuk memulai ada di artikel roadmap belajar AI Engineering dari nol untuk pemula non-IT.
Apa saja tools yang paling sering dipakai untuk membangun sistem RAG?
Tools yang paling umum adalah LangChain atau LlamaIndex sebagai framework orkestrasi, ditambah vector database seperti Pinecone untuk cloud atau ChromaDB untuk lokal. Untuk embedding model, banyak tim menggunakan layanan dari OpenAI Embeddings atau model open-source dari Hugging Face seperti Sentence-BERT. Kombinasi yang paling umum untuk belajar: LangChain dan ChromaDB.
Apakah semua perusahaan butuh RAG?
Tidak semua, tapi semakin banyak yang membutuhkan. Perusahaan yang paling diuntungkan adalah yang memiliki dokumen internal dalam jumlah besar, data yang sering diperbarui, atau kebutuhan chatbot yang harus menjawab dengan akurasi tinggi dan bisa ditelusuri sumbernya. Perusahaan kecil dengan kebutuhan yang sederhana mungkin cukup dengan prompt engineering saja untuk memulai.
Berapa lama waktu yang dibutuhkan untuk bisa membangun sistem RAG sederhana?
Dengan pemahaman Python dasar dan panduan belajar yang terstruktur, prototipe RAG sederhana bisa dibangun dalam 2 hingga 4 minggu. Untuk sistem RAG yang siap digunakan di lingkungan produksi, dengan skalabilitas dan evaluasi yang proper, biasanya dibutuhkan 3 hingga 6 bulan pengalaman praktis melalui proyek nyata yang mendekati kondisi industri.
RAG Adalah Pintu Masuk ke AI Engineering yang Sesungguhnya
Ada tiga hal yang paling penting untuk dibawa dari artikel ini.
RAG membuat AI lebih dapat diandalkan di dunia nyata. Dengan menghubungkan LLM ke sumber data eksternal yang bisa diperbarui, sistem berbasis RAG bisa menjawab berdasarkan fakta aktual, bukan sekadar prediksi statistik dari data lama. Ini adalah perbedaan yang sangat nyata ketika AI dipakai di konteks bisnis yang kritis.
RAG adalah skill konkret yang dibutuhkan industri sekarang. Perusahaan dari sektor perbankan, fintech, HR tech, hingga startup teknologi di Indonesia mulai membangun produk berbasis RAG. Mereka membutuhkan AI Engineer yang memahami arsitektur ini secara mendalam, bisa memilih tools yang tepat, dan bisa mengevaluasi kualitas sistem yang dibangun.
RAG bisa dipelajari siapa pun, termasuk yang belum punya latar belakang IT. Yang dibutuhkan adalah struktur belajar yang tepat dan kesempatan untuk langsung mempraktikkan di proyek yang mendekati kondisi industri nyata. Background akademis bukan syarat utama. Kemampuan membangun dan berpikir secara sistematis adalah yang lebih menentukan.
Jika kamu sedang mempertimbangkan untuk berkarier sebagai AI Engineer, kemampuan memahami dan mengimplementasikan RAG adalah salah satu differentiator terkuat yang bisa kamu miliki di pasar kerja saat ini.
Pelajari RAG bersama mentor praktisi dari Telkom Indonesia, Tiket.com, BCA Digital, dan Traveloka, langsung dalam proyek nyata yang bisa masuk ke portofolio kamu. Cek kurikulum dan jadwal kelas malam di reworkacademy.com/ai-engineering-bootcamp.
Diterbitkan: September 2026 | Referensi: Lewis et al. (2020) “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks,” NeurIPS 2020; Amazon Web Services RAG Documentation; IBM Think Topics: Retrieval-Augmented Generation.